站裡一口氣多了八個影象模型,先說說它們各自的脾氣
這一輪採集把站裡的模型檔案從八個擴到十六個。數量翻倍不是目的,麻煩的是同一句提示詞丟給不同模型,出來的東西差別大到沒法互相參考——所以還是把新來的這八個挨個過一遍,各說各的脾氣。
商用閉源這一檔:GPT Image 1.5 與 Seedream 4.x
GPT Image 1.5 是這批裡案例最多的一個。它的長處在改圖時能把原有的臉和標誌保住,出圖速度也比上一代快,但真正讓它在站內案例裡顯眼的是對長段落描述的消化能力。
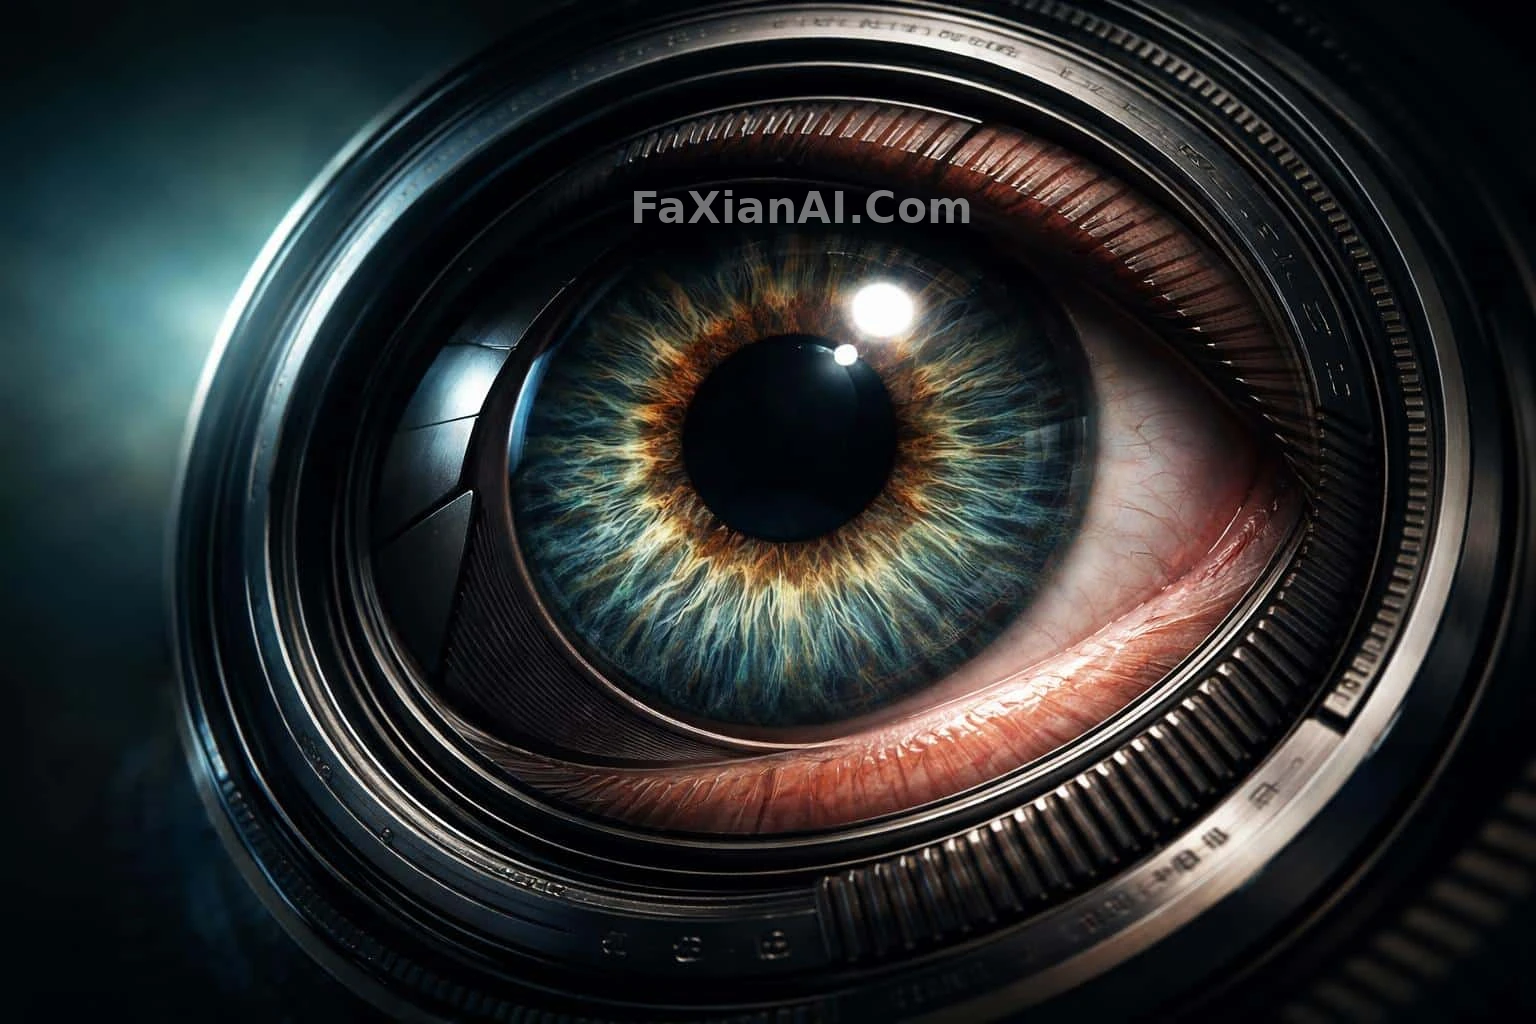
鏡頭長成眼睛的那張可以拿來當例子:金屬和皮膚接壤的那道縫故意沒放在正中間,往右下角斜著滑過去——這種"偏一點"的指令,短句模型往往直接忽略,它卻照做了。裂縫透光的立體字也是同一個道理,裂縫走內部結構不走輪廓,這話說出來它聽得懂。
Seedream 4.0 和 Seedream 4.5 是兩個模型,不是一個。4.5 是 2025 年 12 月的升級版,出圖速度和"改圖時保住主體細節"這兩件事進步最明顯。站內案例的分工也確實分開了:4.0 這邊多是玻璃弧上的夕照、暴風草原上的白牛這類需要色溫分寸的寫實活兒;4.5 這邊則集中在紙箱裡探頭的貓、窗上水珠的微距這類靠焦點取捨說話的題材。
還有一條值得單說:Seedream 系對畫面內文字的處理比多數模型穩,酥皮字母拼出的感恩節標語那種把彩蛋藏在筆畫根部的活兒,靠的就是這個。
專精排版的:Ideogram 4
Ideogram 4 的定位很窄也很清楚——海報、標題字、角色設定表,凡是"字要對、版要正"的活兒它比通用模型省心。
有意思的是站內這批 Ideogram 案例反而多是人像。無邊泳池那張的關鍵變數不是"無邊",是泳池水色和海水色差要趨近於零;回眸的海邊全身像靠的是裙襬和頭髮的甩動幅度要匹配步伐。這說明它對空間關係和運動邏輯的解析同樣紮實,只是排版是它最容易被記住的那面。
開源這一批:Z-Image Turbo、HiDream I1、Krea 2
三個都是開源權重,路子卻各不相同。
Z-Image Turbo 是阿里通義實驗室的 6B 模型,靠極少的取樣步出圖,速度是它最突出的一點。霓虹雨夜的賞金獵人那張裡,地上積水把霓虹複製了第二遍——色彩資訊量翻倍還不用加預算,這種取巧的構圖它接得住。卷軸旁那隻爪子則相反,全場只靠金印那點微光,暗部佔了大半張圖。取樣步數少意味著提示詞寫得越具體越吃香,含糊的形容詞它沒時間猜。
HiDream I1 是 HiDream.ai 的 17B 稀疏擴散模型,寫實和插畫都能接。它在站內的案例反而偏荒誕:斑馬線上遛娃的披薩、從畫框裡塌出來的熔岩。但白底上那頂珍珠頭冠和貓眼墨鏡的產品圖同樣出自它手,說明"什麼都能接"不是空話。
Krea 2 走的是審美路線,四條案例清一色是插畫:花瓣裡的失重瞬間、銀甲女戰士、老樹鑿出來的精靈城。它的強項是兩種風格混合時過渡自然,寫提示詞時與其報一串風格術語,不如描述"這畫面像什麼場合會出現的"。
外放型:Grok Imagine
Grok Imagine 出圖快、風格外放,適合先把腦洞視覺化再換別的模型精修。六張角色卡的選人介面和天鵝絨上的四件兵器都屬於"先看個方向"的用法——後者甚至暴露了一個真問題:四件兵器輪廓差不多,真正拉開辨識度的是刻字字型,而不是造型。這類反饋只有先出圖才能拿到。
怎麼用這些頁面
每個模型頁底下都掛著該模型的全部案例,想找同一模型的寫法參照直接翻模型總覽就好。至於新專案該選誰,站內的模型選擇指南有更系統的對比;具體到提示詞該怎麼搭骨架,提示詞寫作公式那篇更實用;這批新案例裡畫幅交代得比以往清楚,順手可以看畫幅比例該寫在哪一句。
有一件事這半年越來越明顯:模型之間的差距正在從"畫得像不像"轉移到"聽不聽得懂你在說什麼"。同一段描述,有的模型只抓住名詞,有的連"往右下角斜著滑過去"都照做。選模型這件事,越來越像在挑一個理解力合得來的搭檔。