站里一口气多了八个图像模型,先说说它们各自的脾气
这一轮采集把站里的模型档案从八个扩到十六个。数量翻倍不是目的,麻烦的是同一句提示词丢给不同模型,出来的东西差别大到没法互相参考——所以还是把新来的这八个挨个过一遍,各说各的脾气。
商用闭源这一档:GPT Image 1.5 与 Seedream 4.x
GPT Image 1.5 是这批里案例最多的一个。它的长处在改图时能把原有的脸和标志保住,出图速度也比上一代快,但真正让它在站内案例里显眼的是对长段落描述的消化能力。
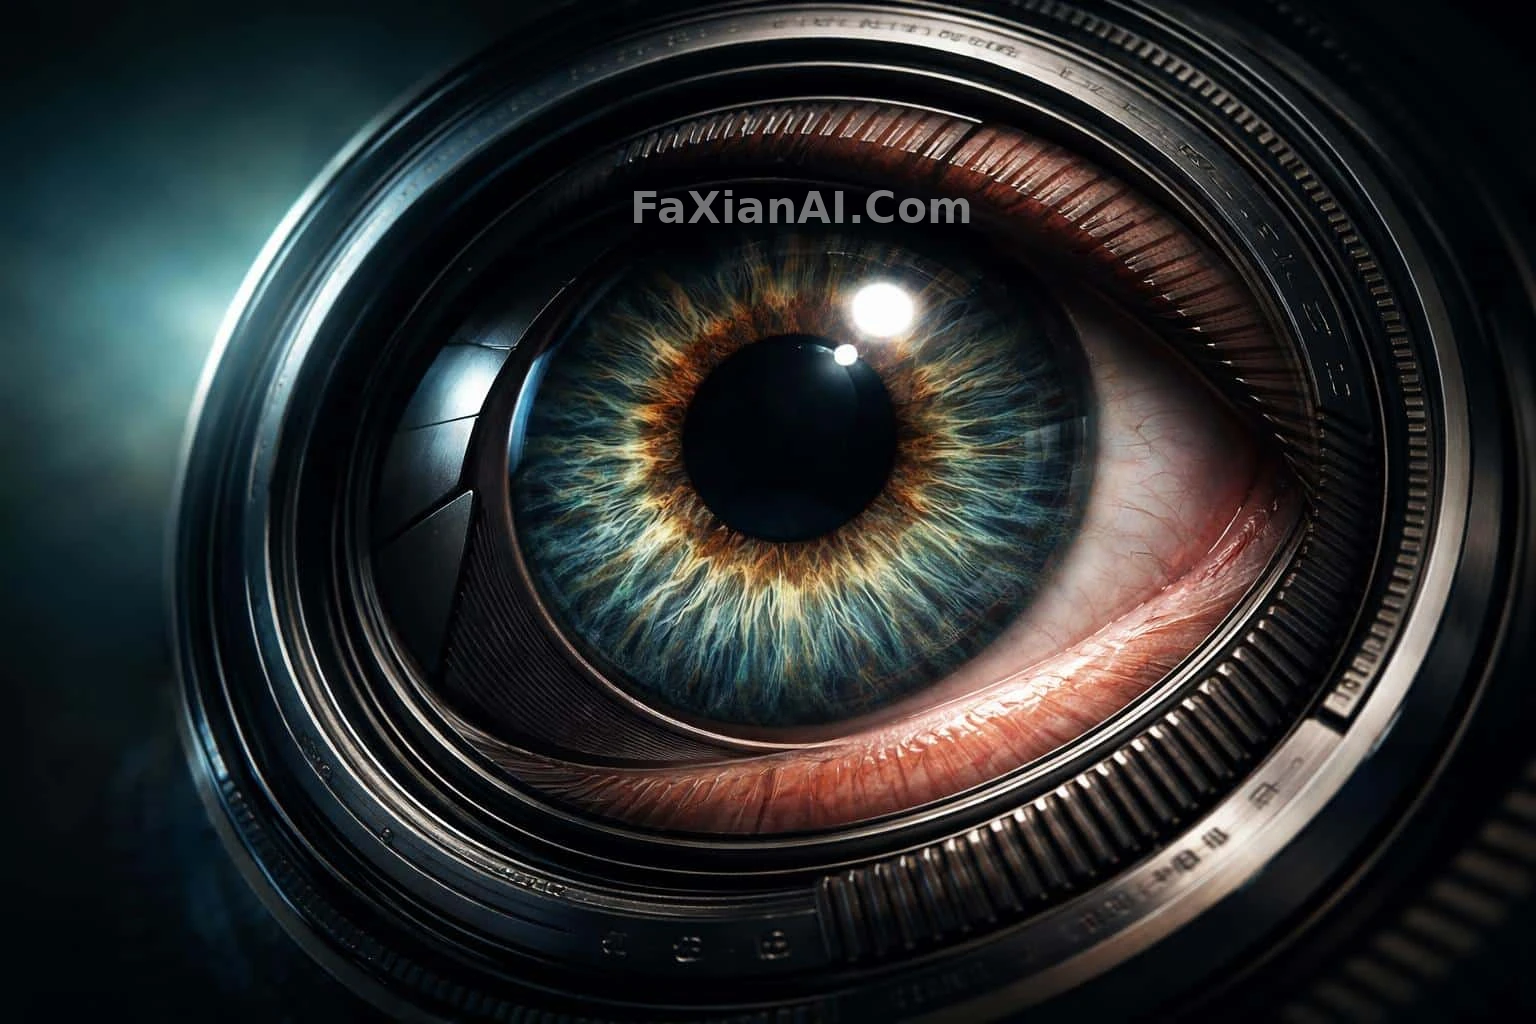
镜头长成眼睛的那张可以拿来当例子:金属和皮肤接壤的那道缝故意没放在正中间,往右下角斜着滑过去——这种"偏一点"的指令,短句模型往往直接忽略,它却照做了。裂缝透光的立体字也是同一个道理,裂缝走内部结构不走轮廓,这话说出来它听得懂。
Seedream 4.0 和 Seedream 4.5 是两个模型,不是一个。4.5 是 2025 年 12 月的升级版,出图速度和"改图时保住主体细节"这两件事进步最明显。站内案例的分工也确实分开了:4.0 这边多是玻璃弧上的夕照、暴风草原上的白牛这类需要色温分寸的写实活儿;4.5 这边则集中在纸箱里探头的猫、窗上水珠的微距这类靠焦点取舍说话的题材。
还有一条值得单说:Seedream 系对画面内文字的处理比多数模型稳,酥皮字母拼出的感恩节标语那种把彩蛋藏在笔画根部的活儿,靠的就是这个。
专精排版的:Ideogram 4
Ideogram 4 的定位很窄也很清楚——海报、标题字、角色设定表,凡是"字要对、版要正"的活儿它比通用模型省心。
有意思的是站内这批 Ideogram 案例反而多是人像。无边泳池那张的关键变量不是"无边",是泳池水色和海水色差要趋近于零;回眸的海边全身像靠的是裙摆和头发的甩动幅度要匹配步伐。这说明它对空间关系和运动逻辑的解析同样扎实,只是排版是它最容易被记住的那面。
开源这一批:Z-Image Turbo、HiDream I1、Krea 2
三个都是开源权重,路子却各不相同。
Z-Image Turbo 是阿里通义实验室的 6B 模型,靠极少的采样步出图,速度是它最突出的一点。霓虹雨夜的赏金猎人那张里,地上积水把霓虹复制了第二遍——色彩信息量翻倍还不用加预算,这种取巧的构图它接得住。卷轴旁那只爪子则相反,全场只靠金印那点微光,暗部占了大半张图。采样步数少意味着提示词写得越具体越吃香,含糊的形容词它没时间猜。
HiDream I1 是 HiDream.ai 的 17B 稀疏扩散模型,写实和插画都能接。它在站内的案例反而偏荒诞:斑马线上遛娃的披萨、从画框里塌出来的熔岩。但白底上那顶珍珠头冠和猫眼墨镜的产品图同样出自它手,说明"什么都能接"不是空话。
Krea 2 走的是审美路线,四条案例清一色是插画:花瓣里的失重瞬间、银甲女战士、老树凿出来的精灵城。它的强项是两种风格混合时过渡自然,写提示词时与其报一串风格术语,不如描述"这画面像什么场合会出现的"。
外放型:Grok Imagine
Grok Imagine 出图快、风格外放,适合先把脑洞可视化再换别的模型精修。六张角色卡的选人界面和天鹅绒上的四件兵器都属于"先看个方向"的用法——后者甚至暴露了一个真问题:四件兵器轮廓差不多,真正拉开辨识度的是刻字字体,而不是造型。这类反馈只有先出图才能拿到。
怎么用这些页面
每个模型页底下都挂着该模型的全部案例,想找同一模型的写法参照直接翻模型总览就好。至于新项目该选谁,站内的模型选择指南有更系统的对比;具体到提示词该怎么搭骨架,提示词写作公式那篇更实用;这批新案例里画幅交代得比以往清楚,顺手可以看画幅比例该写在哪一句。
有一件事这半年越来越明显:模型之间的差距正在从"画得像不像"转移到"听不听得懂你在说什么"。同一段描述,有的模型只抓住名词,有的连"往右下角斜着滑过去"都照做。选模型这件事,越来越像在挑一个理解力合得来的搭档。