一次出三面:角色设定图的提示词里,哪些东西必须写死
单张出图失手了重跑一次就行。设定图不一样——一张图里同时出三个到十二个画面,任何一处没写死,整张就废了。麻烦的地方在于,不同类型的设定图,"必须写死的那一处"根本不是同一件事。
转身三视图:锁比例,不锁姿势
三视图的唯一任务是让同一个角色在不同角度下还认得出来。灰猫和棕鼠的三视图把这件事写得最直白:正视、侧视、背视、四分之三视同框,`proportions locked identical across every angle`——比例在每个角度上完全一致,这一句是整张图的地基。红项圈、奶油色口鼻、琥珀色眼睛这些标识物则要在每个角度重复点名一次,模型才不会在背面把它们忘掉。
反过来说,姿势不该锁死。锁了姿势就成了同一张图旋转四次,看不出体积。
哪吒的三视图提供的是另一种省事写法:格式和分区直接从参考图继承,提示词只负责说"换成谁"。这条路的前提是你手上已经有一张排版满意的设定表——先把框架跑对,再拿它当模具去套新角色,比每次从零描述分区顺序可靠得多。
写法:三视图的提示词至少要有两句是重复的——一句锁比例,一句列标识物。
角色板:信息密度靠分区,不靠堆
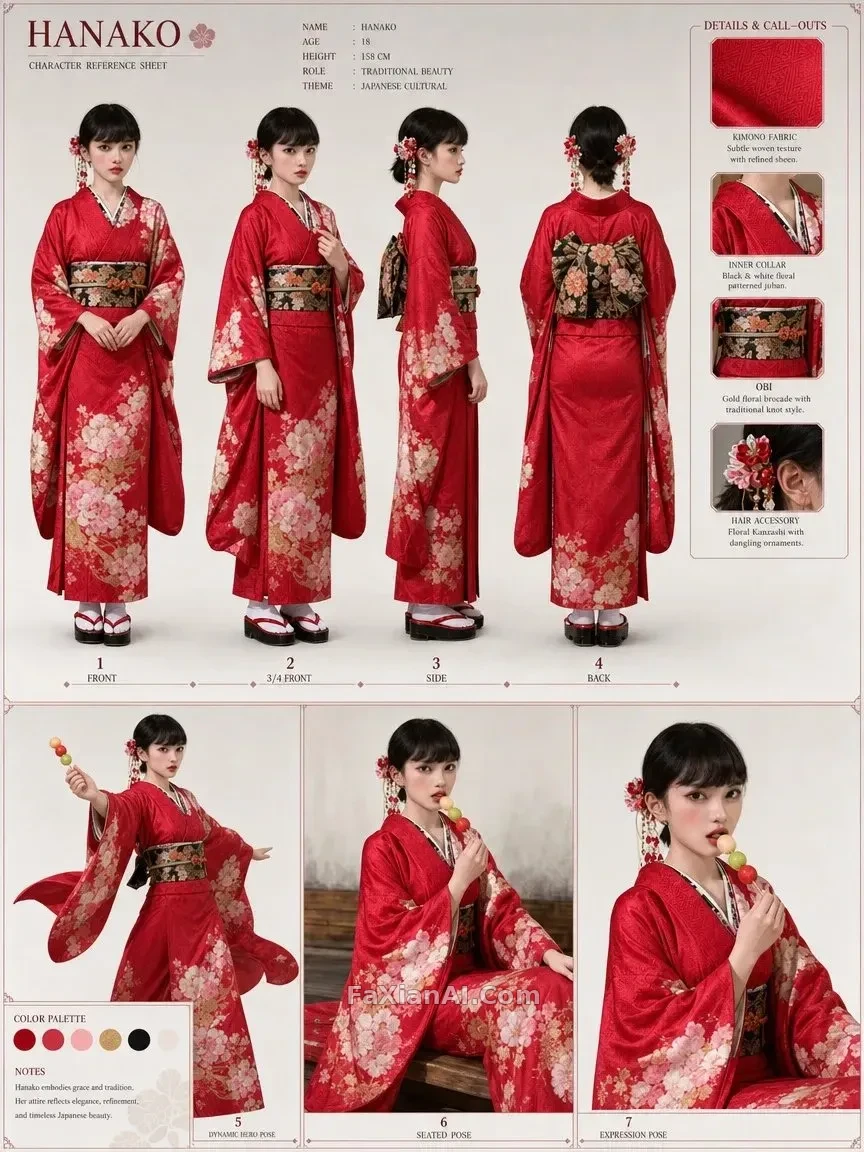
设定表不只是三视图,还得挂色卡、发型细节、姿态小图。和风角色设定表那张的经验是:拼贴的信息密度不是画得越满越好,色卡、姿态、发型三块必须各占一格结构,一散就成了素材墙。它的提示词里还留了一句"脸部按参考图保持模糊匿名",成图却把七格里的脸全画清楚了——这类禁止性指令模型执行得并不稳。真要匿名,靠构图(背影、遮挡、裁切)比靠一句话可靠。
水彩混合媒材的旅行程序员角色板走的是相反方向:画面元素不多,靠笔触密度分层次。涂鸦式小人和拆解图的笔触密度差要拉开,否则整版糊成一团速写。
多格对照:把常量和变量分开写
严格说这不算设定图,但它解决的是同一类问题——同一个人在不同设定下的样子。
四格男装情绪对照只有一个常量:那张下颌线明确的脸。其余四格里衣服、姿态、光、氛围全换。真正撑起可读性的是光源系统——冷白、暖丝绒、逆光、日光暖光四种一一对应,光对了,衣服的时代属性也就跟着立住了。
赛博朋克狐猴混种角色则暴露了混种设定最容易翻车的地方:尾巴、额外附肢这类结构如果没有功能解释,就只能当装饰挂着。写混种时给每处非人结构派一个用途,可信度立刻不一样。
分镜与信息图:顺序才是骨架
十二格电影感分镜看着像设计题,本质是信息图。4x3 网格、逐格编号、每格标题加要点——决定它成不成立的是叙事顺序,配色和标题只是装饰层。十二格已经逼近可读上限,写的时候先把顺序写清楚,风格词往后放。
从照片起步的那条捷径
一张照片起手的三视图版画和特攻服机车少年的 3D 设定图是同一条思路的两个方向:先给参考照片,让模型负责补齐角度,你只描述目标质感。后者还留了个 `gender` 变量位,同一套服装设定可以直接切男版女版——这种把可变项从正文里拎出来做成显式变量的写法,比每次改写整段提示词稳得多。
写法:照片起手时,"发型、服装细节保持统一"这句必须单独写一遍,不能指望模型从参考图里自己推。
---
想先解决"同一个人在不同场景里长得不一样"这件更基础的事,人物一致性那篇更对症;把变量位写成规范字段的做法,结构化提示词写法里有完整字段设计;更多这类多视图与角色设计成图集中在插画分类下。